La experiencia equivalente es el criterio que una rúbrica no puede codificar
Las rúbricas se escriben para la candidatura promedio. Si la solicitud viene de alguien que hizo el mismo trabajo con otro título, en otro campo, o sin la calificación exigida, la rúbrica no tiene categoría para ese caso.
Esas personas suelen ser el encaje más fuerte, y son las primeras que un filtro de palabras clave descarta. Cuando decides que la experiencia obtenida sin educación formal cumple un requisito escrito como un título, estás juzgando la sustancia, no las etiquetas.
El riesgo de sesgo también hay que declararlo con claridad. Un modelo que considera la equivalencia también puede ponderar el prestigio, los nombres de empleadores conocidos y un estilo de escritura asociado al origen de una persona. Restringir la evaluación a los criterios escritos y exigir un pasaje citado para cada juicio deja el razonamiento abierto a inspección. Esos límites no aseguran la neutralidad.
Por eso la salida son notas con citas, el número de salidas está limitado, y una persona lee cada solicitud sin importar lo que el agent haya dicho.
Cómo se construye el agent en Agent Studio
Los prompt skills declaran los límites. Incluyen cada requisito, el tipo de evidencia que lo satisface, y lo que no cuenta: las señales que decidiste que no son relevantes, como el nombre de la institución o del empleador.
La cita es obligatoria porque el system prompt exige un pasaje de respaldo para cada juicio, incluye "no evidenciado" como resultado posible, y prohíbe cualquier puntaje general, ranking o recomendación. Los motivos para tratar dos cosas como equivalentes sí se permiten. Una conclusión sobre una candidatura, no.
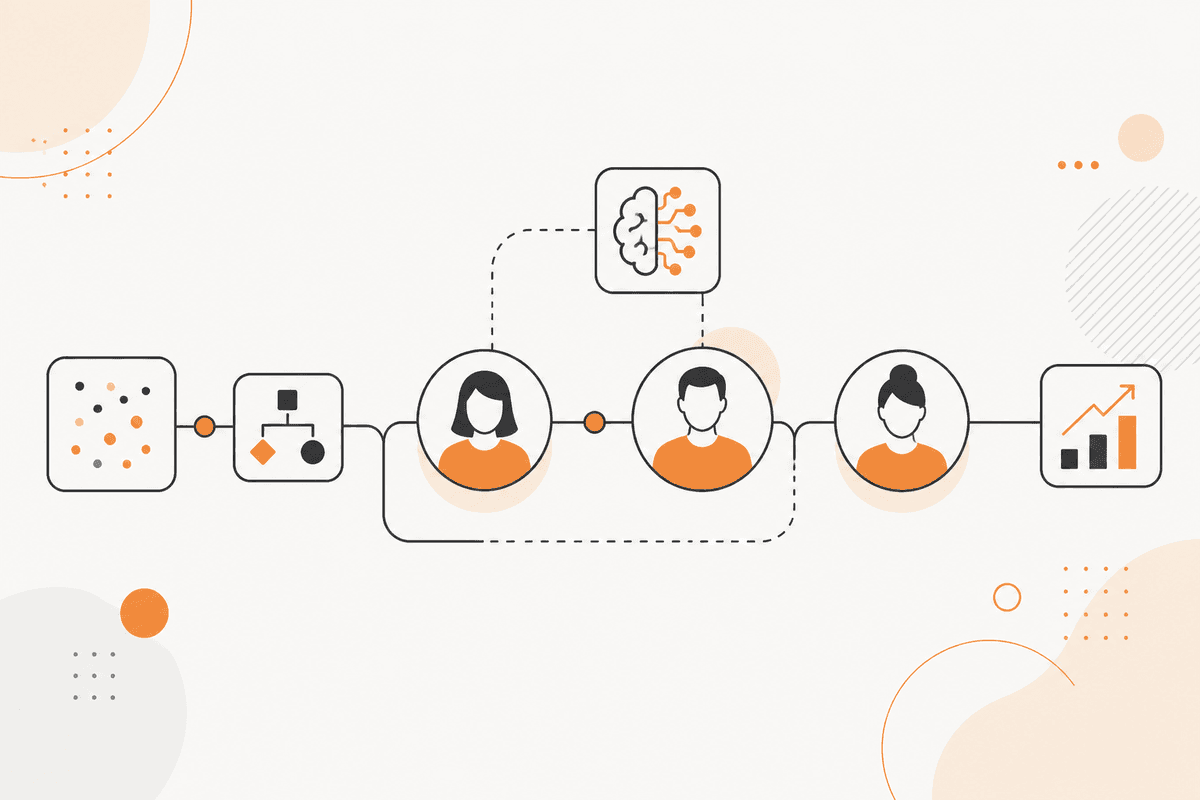
Un nodo Airtable guarda las solicitudes y recibe las notas. El flujo de cribado envía después cada solicitud analizada al nodo Agent Chat.
Los resultados son exactamente el conjunto exigido: cumplido, solo cumplido en parte, o no evidenciado, cada uno con el pasaje, más una sección aparte para cualquier argumento de equivalencia. Quien revisa debería leer primero esa sección de equivalencia.
El agent nunca rechaza una solicitud. Cada solicitud va a una cola humana con las notas, en el orden que da el conteo del flujo.
La única forma de encontrar casos en los que el agent se saltó de forma consistente un tipo de trayectoria es buscar el hueco. Haz de eso una rutina mensual, no una revisión que corres solo en la semana posterior al lanzamiento. Google Sheets registra las evaluaciones del agent junto a las decisiones finales de quien revisa.
De qué está hecho este agent
- Prompt skills: la rúbrica, qué satisface cada requisito, y las señales que de forma explícita no son relevantes.
- System prompt: un pasaje citado por juicio, y ningún puntaje, ranking ni recomendación permitidos.
- Agent Chat (Util): recibe cada solicitud analizada del flujo de cribado.
- Airtable (Integration): guarda las solicitudes y recibe las notas junto a cada una.
- Campo de equivalencia: se devuelve por separado, porque es el criterio que más necesita revisar quien evalúa.
- Google Sheets (Integration): registra evaluaciones contra las decisiones de quien revisa, para la revisión mensual de sesgo.
- Cuando un ActionFlow basta: Si solo necesitas verificar una certificación exigida, construye el flujo de trabajo. Juzgar la equivalencia es el trabajo del agent, y una persona igual lee todo.
Preguntas frecuentes
Empieza a crear flujos de IA
Crea una cuenta gratuita, abre una plantilla o un lienzo en blanco y ejecuta tu primer ActionFlow.
Boletín
Recibe actualizaciones del producto
Nodos nuevos, agents y notas de producto. Solo enviamos correo cuando merece la pena abrirlo.