Aus ihrem Incident wird etwa vierzig Minuten später Ihrer
Ihre Systeme hängen von Services ab, die Sie nicht betreiben, und wenn einer beeinträchtigt ist, ist das erste Signal meist Ihre eigenen Nutzerinnen und Nutzer. Der Lieferant hat zwanzig Minuten früher ein Statusupdate gepostet, auf einer Seite, die niemand offen hatte.
Alle auf jede Statusseite zu abonnieren, scheitert in die andere Richtung: ein Anbieter postet wöchentlich Wartungshinweise, die meisten irrelevant, und die Benachrichtigungen werden innerhalb eines Monats gefiltert.
Die nützliche Fassung ist eng. Nur die Services, von denen Sie abhängen, nur die Komponenten, die Sie tatsächlich nutzen, geleitet an das Team, dessen Arbeit stoppt, nicht in einen allgemeinen Kanal.
Früh zu wissen, behebt selten etwas, und es ändert den Tag trotzdem. Vierzig Minuten zu wissen, dass es nicht Ihr Bug ist, sind vierzig Minuten, die nicht mit der Suche nach einem verbracht werden.
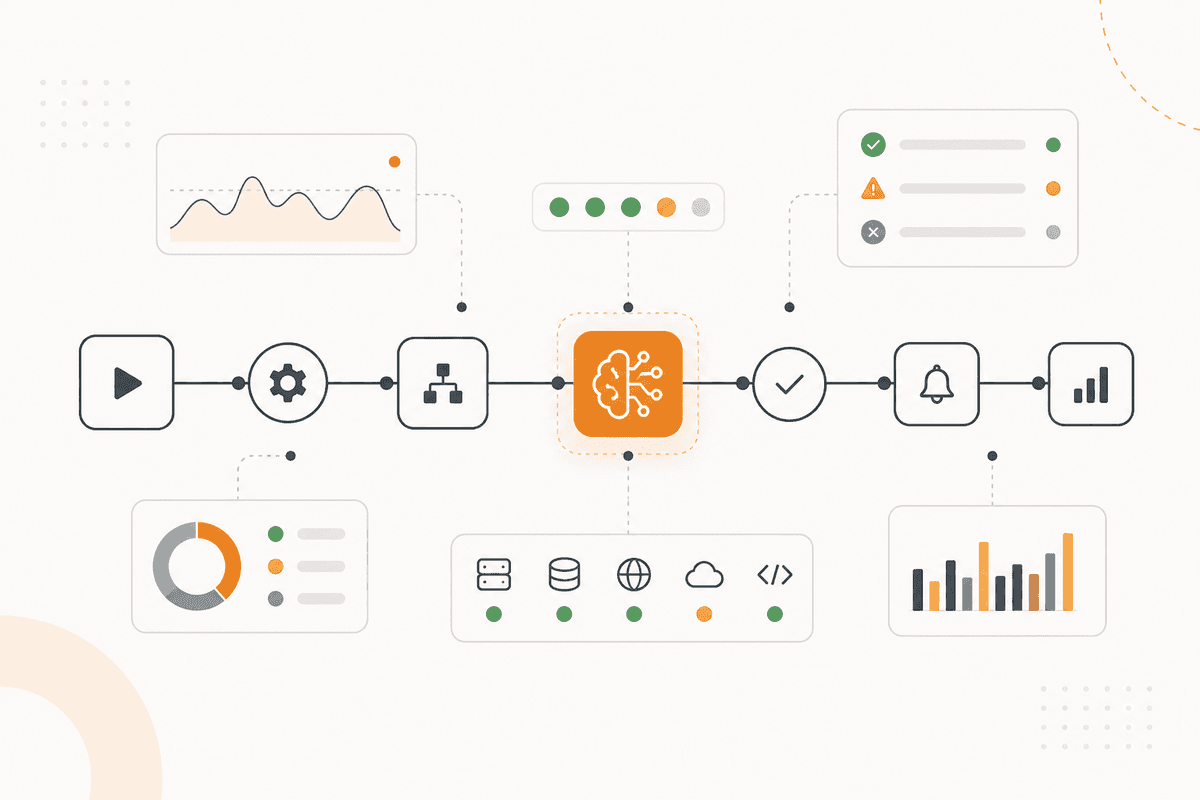
So läuft der ActionFlow auf der Canvas
Statusseiten werden von einem HTTP Request-Knoten gelesen, wo der Lieferant einen maschinenlesbaren Feed veröffentlicht, und von Scrappey, wo nur eine Webseite existiert.
Ein Start Scheduled-Knoten führt die Prüfung in Ihrem Intervall aus, und ein Loop-Knoten geht die Lieferantenliste durch, mit den Komponenten, die Sie nutzen, gegen jeden erfasst.
Ein Filter-Knoten verwirft jeden Incident, der nur Komponenten berührt, die Sie nicht nutzen, sodass der Großteil des Volumens der größeren Anbieter entfällt.
Ein Text Classifier-Knoten sortiert den Rest danach, ob er Beeinträchtigung, einen vollständigen Ausfall oder einen Wartungshinweis beschreibt, weil jedes eine andere Bearbeitung verlangt.
Ein PostgreSQL-Knoten hält offene Incidents, und ein If-Knoten unterscheidet einen neuen Incident von einem Update zu einem bereits gemeldeten. Das ist der Unterschied zwischen Informieren und wiederholtem Unterbrechen.
Ein Generate Text-Knoten schreibt die Benachrichtigung in Ihren eigenen Begriffen und nennt, welche Ihrer Systeme von der betroffenen Komponente abhängen.
Ein Switch-Knoten leitet über Slack oder Teams an das besitzende Team, und ein Notion-Knoten hält das Protokoll, das ein Lieferantenreviewgespräch belegbasiert macht.
Knoten, die dieser ActionFlow verwendet
- Start Scheduled (Start): das Abfrageintervall.
- HTTP Request (Util) with Scrappey (Util): Statusfeeds und Seiten ohne Feed.
- Loop (Control): geht die Lieferantenliste durch, mit Ihren genutzten Komponenten erfasst.
- Filter (Data): verwirft Incidents, die Komponenten berühren, die Sie nicht nutzen.
- Text Classifier (AI Custom): Beeinträchtigung, Ausfall oder Wartung.
- PostgreSQL (Data) with If (Control): ein neuer Incident gegen ein Update zu einem offenen.
- Switch (Control) with Slack (Communication): leitet an das Team, dessen Arbeit stoppt.
- Notion (Integration): das Protokoll, das Lieferantenreviews belegbasiert macht.
Häufige Fragen
Newsletter
Produktupdates erhalten
Neue Nodes, Agents und Produktnotizen. Wir senden E-Mails nur, wenn sich das Öffnen lohnt.