Andere Formulierung ist keine Uneinigkeit
Ein Modellvergleich nebeneinander liefert Ihnen einen langen Textblock ohne Schluss. Die meisten Unterschiede sind nur Formulierung. Die wenigen wichtigen Unterschiede verstecken sich in diesem Rauschen: ein Modell nennt eine andere Zahl, eines gibt eine Empfehlung, die das andere nicht gibt, oder eines enthält eine Warnung, die das andere ausgelassen hat.
Um sie zu trennen, müssen Sie auf Bedeutung lesen, nicht nur auf Unterschiede. Zwei Antworten können fast kein Vokabular teilen und trotzdem dasselbe meinen. Zwei andere können fast identisch sein und trotzdem in dem einen Satz uneinig, der das Ergebnis entscheidet.
Ein weiterer Fund erscheint nur, wenn Sie genau lesen. Manchmal hat Divergenz nichts mit Modellqualität zu tun. Sie bedeutet, dass der Prompt mehrdeutig war und jedes Modell ihn anders gelesen hat. Das ist oft das nützlichste Ergebnis eines Vergleichs, und ein Diff-Tool kann es nicht erkennen.
So bauen Sie den Agent in Agent Studio auf
Der System-Prompt definiert für Ihren Anwendungsfall, was ein inhaltlicher Unterschied ist. Er weist den Agent außerdem an, Prompt-Mehrdeutigkeit als eigene Kategorie zu behandeln, nicht als Modellqualität.
Die Bewertungskriterien, die Sie setzen, bestimmen, was in Ihrem Bereich als gute Antwort gilt, und die Fehlerbilder, die für Sie am meisten zählen.
Weil ActionFlows mit 83 Modellanbietern verbunden ist, ist die Wahl des Vergleichssets Konfiguration, kein Integrationsprojekt. Sobald ein Anbieter unter Anmeldedaten verbunden ist, stehen seine Modelle jedem Knoten und jedem Agent zur Verfügung.
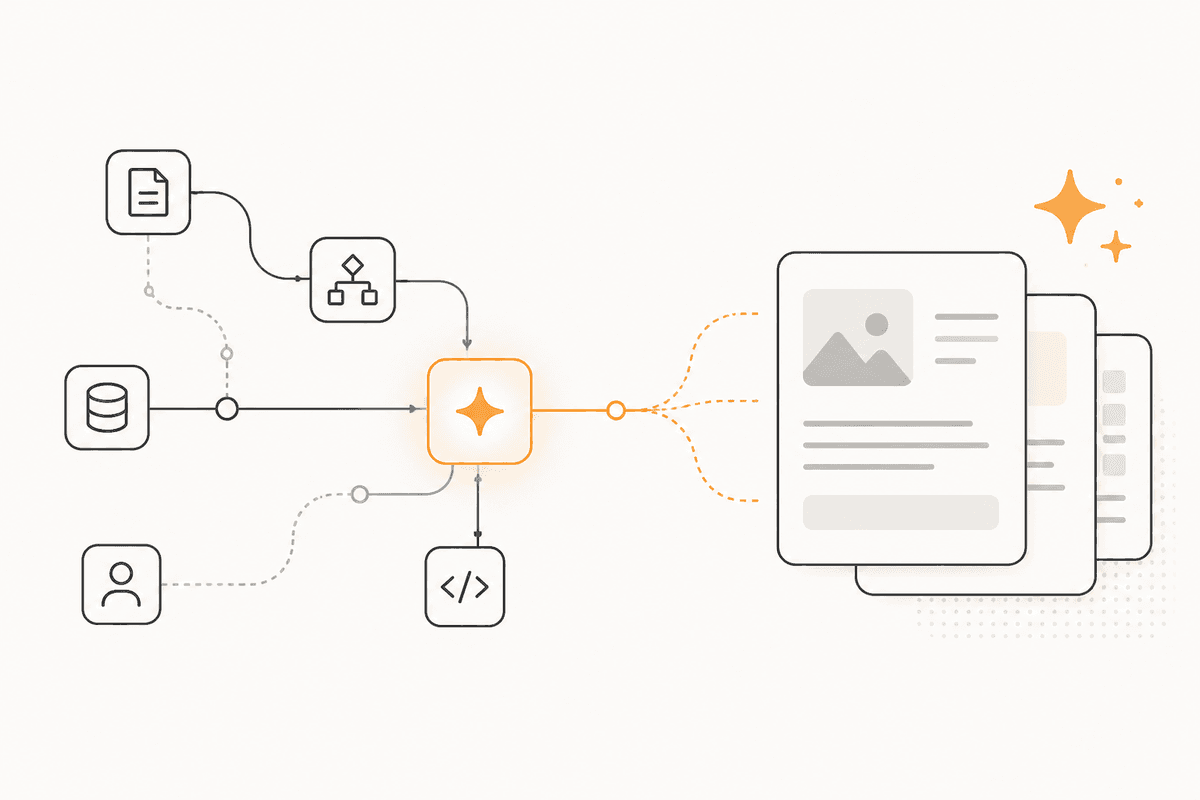
Der Flow funktioniert am besten, wenn er die Prompts sendet. In diesem Aufbau sendet ein ActionFlow denselben Prompt an mehrere Generate Text-Knoten, jeder an einen anderen Service gebunden, und übergibt die Ausgaben über den Agent Chat-Knoten an den Agent. Der Agent führt die Einschätzung aus. Jeder KI-Knoten berichtet Tokenverbrauch und Kosten in seiner Ausgabe, sodass Sie Qualitätsurteil und Preisvergleich im selben Lauf bekommen, ohne extra Instrumentierung.
Behalten Sie die Rohausgaben, weil Sie dem Urteil irgendwann widersprechen werden. Der einzige Weg, das zu klären, ist, die Quellen erneut zu lesen.
Woraus dieser Agent besteht
- System-Prompt: was als inhaltlich gilt, und die Anweisung, Prompt-Mehrdeutigkeit getrennt zu markieren.
- Prompt-Fähigkeiten: Ihre Bewertungskriterien und die Fehlerbilder, die Ihnen wichtig sind.
- Generate Text (AI Core): mehrere Knoten in einem Flow, jeder auf einem anderen Modell-Service.
- Agent Chat (Util): übergibt die gesammelten Ausgaben dem Agent zur Einschätzung.
- Kostenausgaben der Knoten: Qualitätsurteil und Preisvergleich entstehen im selben Lauf.
- Google Sheets (Integration): protokolliert Urteile, sodass Vergleiche wiederholt werden können, wenn sich Modelle ändern.
- Wenn ein ActionFlow ausreicht: Führen Sie routinemäßiges Kosten- und Latenz-Benchmarking aus, bauen Sie einen Workflow mit einem Bewertungsschritt. Nutzen Sie den Agent, wenn Qualität die Frage ist.
Häufige Fragen
Newsletter
Produktupdates erhalten
Neue Nodes, Agents und Produktnotizen. Wir senden E-Mails nur, wenn sich das Öffnen lohnt.