Leur incident devient le vôtre avec environ quarante minutes de retard
Vos systèmes dépendent de services que vous ne faites pas tourner, et lorsque l'un se dégrade, le premier signal est en général vos propres utilisateurs. Le fournisseur a publié une mise à jour de statut vingt minutes plus tôt, sur une page que personne n'avait ouverte.
Abonner tout le monde à chaque page de statut échoue dans l'autre sens : un fournisseur publie des avis de maintenance chaque semaine, la plupart hors sujet, et les notifications se retrouvent filtrées en un mois.
La version utile est étroite. Seulement les services dont vous dépendez, seulement les composants que vous utilisez réellement, acheminés vers l'équipe dont le travail s'arrête plutôt que vers un canal général.
Savoir tôt ne répare presque jamais rien, et cela change pourtant la journée. Quarante minutes à savoir que ce n'est pas votre bug, ce sont quarante minutes non passées à en chercher un.
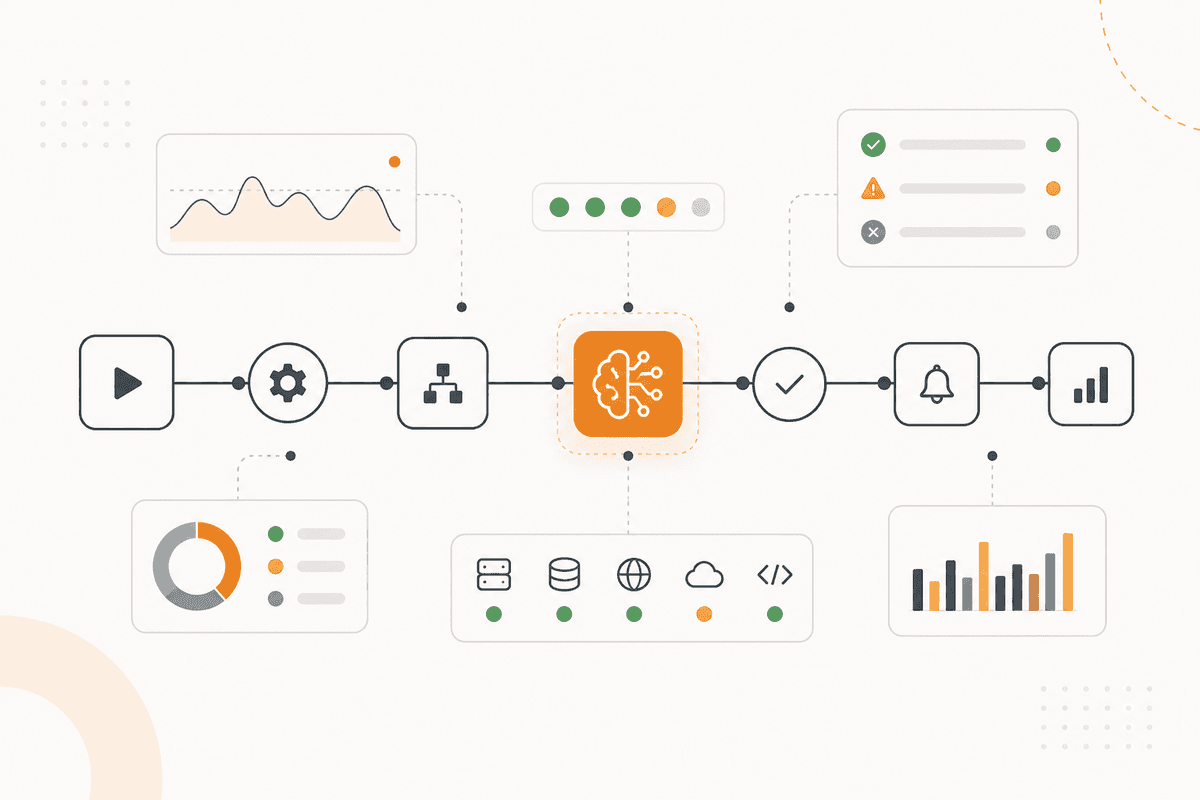
Comment l'ActionFlow s'exécute sur le canevas
Les pages de statut sont lues par un nœud HTTP Request lorsque le fournisseur publie un flux lisible par machine, et par Scrappey lorsqu'il n'existe qu'une page web.
Un nœud Start Scheduled mène le contrôle selon votre intervalle, et un nœud Loop parcourt la liste des fournisseurs, les composants que vous utilisez étant enregistrés contre chacun.
Un nœud Filter écarte tout incident qui ne touche que des composants que vous n'utilisez pas, ce qui retire l'essentiel du volume des plus gros fournisseurs.
Un nœud Text Classifier trie ce qui reste selon qu'il décrit une dégradation, une panne complète, ou un avis de maintenance, parce que chacun exige un traitement différent.
Un nœud PostgreSQL tient les incidents ouverts, et un nœud If distingue un nouvel incident d'une mise à jour d'un incident déjà rapporté. C'est la différence entre informer les gens et les interrompre à répétition.
Un nœud Generate Text rédige la notification dans vos propres termes, en nommant lesquels de vos systèmes dépendent du composant touché.
Un nœud Switch achemine vers l'équipe propriétaire via Slack ou Teams, et un nœud Notion tient le journal qui rend une conversation de revue fournisseur fondée sur des preuves.
Nœuds utilisés par cet ActionFlow
- Start Scheduled (Start) : l'intervalle d'interrogation.
- HTTP Request (Util) avec Scrappey (Util) : flux de statut et pages qui n'ont pas de flux.
- Loop (Control) : parcourt la liste des fournisseurs, vos composants utilisés étant enregistrés.
- Filter (Data) : écarte les incidents qui touchent des composants que vous n'utilisez pas.
- Text Classifier (AI Custom) : dégradation, panne ou maintenance.
- PostgreSQL (Data) avec If (Control) : un nouvel incident contre une mise à jour d'un incident ouvert.
- Switch (Control) avec Slack (Communication) : achemine vers l'équipe dont le travail s'arrête.
- Notion (Integration) : le journal qui rend les revues fournisseurs fondées sur des preuves.
Questions fréquentes
Newsletter
Recevoir les mises à jour produit
Nouveaux nœuds, agents et notes produit. Nous n'envoyons un e-mail que lorsqu'il vaut la peine de l'ouvrir.